


Les entreprises prennent constamment des décisions marketing stratégiques à partir de volumes importants de données, sans forcément parvenir à dégager des insights actionnables. Les chiffres sont là pour une étude statistique, mais beaucoup n’arrivent pas à comprendre les relations qui existent entre les variables : âge et comportement d’achat, sexe et type de produit, canal et fidélité. Faute d’analyse croisée entre les variables, les choix stratégiques que prennent certaines entreprises reposent encore trop souvent sur l’intuition plutôt que sur un résultat mesurable. Identifier les facteurs réellement déterminants devient alors complexe, notamment pour l’étude de la satisfaction client, de la préférence produit ou de réachat par exemple.
Heureusement, le tableau de contingence répond précisément à ce besoin. Cet outil permet de croiser des caractères d’une population pour mettre en évidence une relation, une dépendance ou une corrélation entre plusieurs variables. En s’appuyant sur des calculs simples, il apporte une lecture claire et structurée de données issues d’une étude qualitative ou encore quantitative. Les résultats obtenus permettent d’analyser la relation entre deux (ou plusieurs) variables qualitatives ou encore de comparer les comportements entre groupes. Indispensable dès qu’il s’agit de comprendre, comparer et décider à partir de données clients, dans cet article découvrez tout ce qu’il y a à savoir sur le tableau de contingence !
Qu’est-ce qu’un tableau de contingence ?
Une expression introduite par Karl Pearson en 1904, un tableau de contingence est un outil central de la statistique descriptive. Très utile pour les entreprises, au même titre que le diagramme d’Ishikawa, il sert à analyser la relation entre deux variables qualitatives et permet d’organiser des données afin d’observer comment se répartissent les individus selon une combinaison de caractéristiques. Concrètement, il s’agit d’un tableau à double entrée dans lequel les lignes représentent les modalités d’une variable (par exemple le sexe) et les colonnes celles d’une autre variable (par exemple un produit). Chaque cellule indique le nombre d’individus correspondant à cette combinaison précise.
Un tableau de contingence croisant deux variables révèle la fréquence à laquelle deux caractéristiques apparaissent ensemble. Cette fréquence peut être exprimée de manière absolue (effectifs) ou relative (pourcentages), ce qui aide à mesurer les liens entre variables et à mieux interpréter les résultats. L’objectif n’est pas seulement de compter, mais de comprendre le comportement observé dans une population.
Prenons un exemple simple : en colonne, trois produits alimentaires (gâteau, glace, donut) ; en ligne, le sexe (homme / femme). Le tableau indique, par exemple, combien de femmes choisissent la glace et combien d’hommes préfèrent le donut. En comparant les pourcentages par ligne ou par colonne, on arrive à identifier des préférences marquées et détecter une éventuelle relation entre sexe et choix du produit.
| Sexe / Produit | Gâteau | Glace | Donut | Total |
|---|---|---|---|---|
| Homme | 20 | 35 | 45 | 100 |
| Femme | 40 | 50 | 30 | 120 |
| Total | 60 | 85 | 75 | 220 |
Un autre exemple lié au sexe peut concerner un service : abonnement standard ou premium selon qu’il s’agit d’un homme ou d’une femme.
| Sexe / Abonnement | Standard | Premium | Total |
|---|---|---|---|
| Homme | 70 | 30 | 100 |
| Femme | 50 | 70 | 120 |
| Total | 120 | 100 | 220 |
Là encore, le tableau aide à visualiser rapidement les différences de répartition. Cet outil simple répond à un problème clé en statistique, celui de détecter l’existence de dépendances entre des caractéristiques observées. Lorsqu’une dépendance est identifiée, on peut créer une lecture plus synthétique et exploitable des résultats d’enquête.
Enfin, sachez que savoir exploiter un tableau de contingence est un pré requis du marketing de base de données, car il permet d’analyser concrètement les relations entre profils clients, comportements et performances marketing. Sans cette compétence, il est impossible de segmenter efficacement, de tester des hypothèses et de prendre des décisions data-driven fiables.
Comment créer un tableau de contingence ?
Voici les étapes à suivre pour créer un tableau de contingence :
Étape 1 : Identifier les variables catégorielles
La première étape consiste à choisir les variables à croiser. Un tableau de contingence fonctionne avec des variables catégorielles, c’est-à-dire composées de catégories distinctes (sexe, type de produit, canal d’achat). Lorsqu’une variable est quantitative (âge, revenu, montant d’achat), elle doit être catégorisée. Cela consiste à regrouper des valeurs numériques en classes pertinentes, par exemple : 18-25 ans, 26-35 ans, 36-50 ans. Cette étape est souvent négligée, alors qu’un mauvais découpage fausse l’analyse et rend les résultats difficiles à interpréter.
Étape 2 : Définir les modalités
Chaque variable doit ensuite être découpée en modalités claires, exclusives et exhaustives. Aucune catégorie ne doit se chevaucher, et toutes les réponses possibles doivent être couvertes. Par exemple, pour la variable « sexe » : Homme / Femme ; pour la variable « préférence de boisson » : Café / Thé / Eau. Une erreur fréquente que beaucoup de personnes commettent à cette étape est d’oublier une modalité, ce qui entraîne une perte d’information et des totaux incohérents dans le tableau final.
Étape 3 : Comptabiliser les fréquences
Pour chaque combinaison de modalités (ex. : Homme × Café), il faut compter le nombre exact d’observations correspondantes dans le jeu de données. Ce comptage doit être fait ligne par ligne, sans approximation. Ne commettez pas l’erreur de compter des réponses multiples comme une seule observation ou mélanger individus et réponses.
Étape 4 : Ajouter les totaux marginaux
Les totaux marginaux correspondent à la somme des effectifs par ligne et par colonne. Pour les calculer, additionnez simplement toutes les cellules d’une même ligne pour obtenir le total ligne, puis toutes celles d’une colonne pour le total colonne. Ces totaux serviront à calculer des pourcentages, comparer des proportions et analyser les écarts entre catégories.
Étape 5 : Vérifier la cohérence des données
La somme de tous les effectifs du tableau doit être strictement égale au nombre total d’observations du jeu de données initial. Pour vérifier cela, additionnez les totaux de lignes ou de colonnes et comparez le résultat au nombre d’individus analysés. Une différence indique une erreur de saisie, un doublon ou une modalité oubliée, qu’il faut corriger avant toute interprétation.
Dans les logiciels ou tableurs (R, SPSS, Excel), vous trouverez des fonctions ou menus dédiés (ex. table, crosstabs ou tableau croisé dynamique) qui automatisent ces étapes.
Quelle est l’utilité d’un tableau de contingence ?
Un tableau de contingence sert à synthétiser l’information et à mettre en lumière des relations entre variables qui ne seraient pas évidentes à partir des données brutes. Plus en détail, cet outil vous sera utile pour :
Synthèse des données
Un tableau de contingence résume efficacement des grands volumes de données en une structure lisible, avec des fréquences et des proportions qui montrent la répartition des modalités de variables. La manière dont le tableau présente les données simplifie le repérage de tendances et la comparaison entre catégories.
Analyse des relations
En croisant deux variables, le tableau vous offre la possibilité d’évaluer visuellement et statistiquement si elles sont associées ou indépendantes :
- Si les proportions sont similaires entre lignes ou colonnes, les variables sont probablement indépendantes.
- Si elles varient, il peut exister une relation
Base des tests statistiques
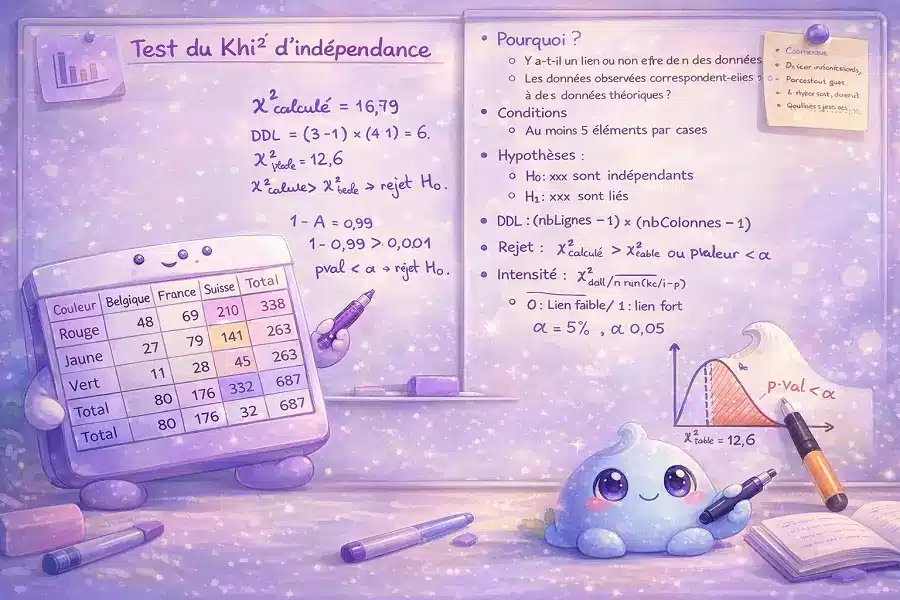
Les tableaux de contingence sont la base de tests comme le chi-deux d’indépendance ou le test exact de Fisher, indispensables pour déterminer si une relation observée est statistiquement significative.
Applications : analyse des comportements sociaux, aide à la décision en marketing…
En recherche sociale, le tableau de contingence sert à comparer des groupes d’individus en croisant des caractéristiques sociodémographiques avec des attitudes ou des pratiques. Il aide à comprendre comment le sexe, l’âge ou le niveau d’études influencent des comportements sociaux et à mettre en évidence des différences structurantes au sein d’une population. Cette compréhension est notamment indispensable pour structurer des décisions efficaces et cohérentes en marketing ciblé en entreprise, en s’appuyant sur des segments réellement différenciés.
En marketing, cet outil sert à analyser le comportement des consommateurs en croisant profils clients et choix de produits. Le Data analyst/analyste marketing, le chargé d’études marketing, le responsable marketing ou chef de produit ou encore le chargé CRM ou customer data s’en sert pour identifier des segments pertinents, de repérer des préférences dominantes et d’adapter une offre ou une campagne en s’appuyant sur des données concrètes plutôt que sur l’intuition. Une des erreurs en campagnes publicitaires à ne pas commettre est en effet de se baser sur des données non traitées.
Comment lire et analyser les résultats ?
Une fois le tableau de contingence construit, l’objectif est d’en extraire des résultats interprétables.
Les pourcentages conditionnels
Les pourcentages conditionnels se calculent à partir des effectifs observés. Pour le pourcentage en ligne, la formule est la suivante : effectif de la cellule ÷ total de la ligne × 100. Il permet d’analyser le comportement d’un groupe précis. Exemple : parmi les clients jeunes, quelle proportion a acheté ? En marketing, c’est l’indicateur le plus utilisé pour comparer des segments.
Concernant le pourcentage en colonne, la formule se présente comme suit : effectif de la cellule ÷ total de la colonne × 100. Il permet d’analyser la structure globale d’un résultat. Exemple : parmi les acheteurs, quelle proportion est jeune ?
Les fréquences théoriques (ou attendues)
Les fréquences théoriques représentent ce que l’on observerait si les deux variables étaient indépendantes. Formule : (total ligne × total colonne) ÷ total général. Elles servent de référence pour évaluer si la distribution observée est normale ou non.
Interprétation des dépendances
Si les distributions des catégories changent significativement d’une ligne à l’autre, cela suggère un lien entre les variables. Par exemple, si une catégorie est beaucoup plus fréquente pour une modalité que pour une autre, cela indique une relation potentielle entre les variables
Comparaison aux attentes statistiques
Pour une analyse plus rigoureuse, vous devez comparer les fréquences observées aux fréquences attendues sous l’hypothèse d’indépendance (ce que serait le tableau si les variables n’étaient pas liées). Cela constitue la base du test du chi-deux d’indépendance.
On compare chaque cellule observée à sa valeur théorique. Un écart positif indique une surreprésentation Un écart négatif indique une sous-représentation. Cet écart met en évidence les cellules clés, appelées contributions fortes.
Visualisation
Il est possible de représenter les données en barres groupées, diagrammes en mosaïque ou cartes thermiques. Cela facilite la détection de patterns dans des tableaux plus complexes.
Quels tests statistiques utiliser avec un tableau de contingence ?
Plusieurs tests statistiques permettent d’évaluer si une relation observée dans un tableau de contingence est statistiquement significative plutôt que due au hasard. Voici les tests en question :
Test du chi-deux d’indépendance (χ²) : le test du chi-deux de Pearson est le plus utilisé pour vérifier si les variables d’un tableau croisé sont indépendantes. Il compare les fréquences observées aux fréquences attendues en l’absence de lien. Si la valeur du chi calculée est suffisamment élevée, l’hypothèse d’indépendance est rejetée.
Test exact de Fisher : pour de petits effectifs ou des tableaux 2×2 contenant des cellules avec des valeurs faibles (inférieures à 5), le test exact de Fisher est plus adapté que le chi-deux. Il calcule précisément la probabilité d’observer les données sous l’hypothèse d’indépendance.
Correction de Yates : dans certains tableaux 2×2, une correction de continuité de Yates peut être appliquée afin de limiter la surestimation de la relation lorsque les effectifs sont réduits.
Mesures d’association : au-delà de la significativité statistique, cet outil aide aussi à calculer divers indicateurs de performance et des indicateurs comme le V de Cramér ou l’odds ratio permettent d’évaluer l’intensité de la relation entre les variables.
Chaque méthode répond à des conditions d’application spécifiques, d’où l’importance d’un choix adapté au contexte d’analyse.
Comment croiser des variables dans un tableau de contingence ?
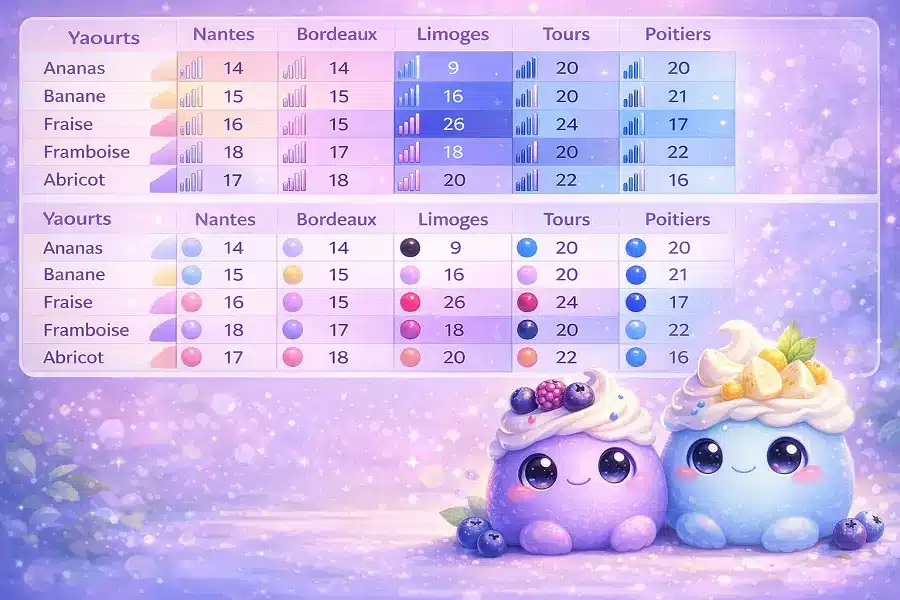
Le croisement de variables consiste à organiser dans un tableau les combinaisons possibles des catégories de plusieurs variables qualitatives.
Deux variables (tableau à 2 dimensions)
Dans un tableau à double entrée, une variable est positionnée sur les lignes et l’autre sur les colonnes. Chaque cellule indique combien d’observations correspondent à une paire de modalités
Trois variables ou plus
Lorsqu’il y a plus de deux variables, vous avez le choix entre :
- Tableaux multidimensionnels (ex. 3-way table) où chaque dimension correspond à une variable.
- Tables de Burt : matrices symétriques qui contiennent tous les tableaux de contingence possibles entre les variables deux à deux.
Tableaux croisés hiérarchiques
Une alternative consiste à stratifier les tableaux : on croise deux variables pour chaque modalité d’une troisième variable (ex. : créer un tableau sexe vs préférence pour chaque tranche d’âge).
Variables ordinales
Lorsque les catégories ont un ordre (ex. : faible/moyen/élevé), vous pouvez afficher les tableaux avec cet ordre, puis calculer des mesures d’association adaptées (ex. Gamma de Goodman & Kruskal, Spearman’s rho). Le choix de la méthode dépend du nombre de variables, de leurs modalités, et des objectifs de l’analyse.
Quelles sont les différentes formes d’analyse croisée ?
L’analyse croisée (ou tabulation croisée / tableau de contingence) est une méthode pour examiner les relations entre deux variables ou plus. Voici ces formes les plus connues :
Tri Croisé Simple (2 variables)
Le tri croisé simple consiste à organiser deux variables qualitatives dans un tableau de contingence ou cross-tabulation permettant de visualiser et analyser la distribution conjointe des catégories : chaque cellule présente la fréquence des combinaisons de modalités. C’est l’outil de base pour observer des associations entre deux variables catégorielles dans des enquêtes ou sondages.
Tri Croisé Multiple (NxN)
Quand on croise plus de deux variables, on parle de tri croisé multiple, représenté par des tableaux multidimensionnels ou multiples tableaux croisés. Cette forme étend l’analyse à des configurations de variables complexes pour extraire des relations plus riches entre ensembles de variables.
Analyse croisée avec données structurées
Certains méthodes explorent des structures internes des données, comme l’Analyse Factorielle des Correspondances (AFC) ou l’Analyse des Correspondances Multiples (ACM), qui offrent la possibilité de structurer et hiérarchiser les informations et d’étudier des relations entre plusieurs variables qualitatives en réduisant les dimensions.
Analyse Quali-Quantitative Comparée (AQQC)
L’AQQC est une méthode qui combine qualitatif et quantitatif pour analyser un petit nombre de cas à l’aide d’une formalisation logique (algèbre booléenne). On l’utilise pour identifier des combinaisons de conditions associées à un résultat dans un cadre comparatif.
